你在豆包里打一句话,两三秒后,它就回你一大段,有条有理,像个什么都懂的专家。
这两三秒里,到底发生了什么?
很多人以为,它背后连着一个巨大的数据库,你一问,它就去里面翻答案。这个想法很自然,但不对。要是真这样,它就不会一本正经地编出根本不存在的书名、法条和数字了。
真实的情况更简单,也更有意思:它从头到尾只干一件事:接话。
一、它在玩一场文字接龙
我说“床前明月”,你脑子里会自动蹦出一个“光”。你没去翻唐诗,只是这句话你见过太多次,后面跟着什么,早就刻在脑子里了。
大模型做的就是这件事,只不过做到了极致:看前面的话,猜下一个字接什么最像。 猜出一个,接上,再拿接长了的整句话去猜下一个,一直接到它觉得该结束了。你看到的那一大段回答,就是这么一个字一个字“接”出来的。
这种读了海量文字、专门干接话这件事的 AI,业内叫大语言模型,简称大模型。豆包、DeepSeek、元宝、ChatGPT,底子都是它。
开了“联网搜索”也一样:搜索是外面的软件替它做的,搜到的网页被塞到你的问题前面,它干的还是接话(《它的知识停在某一天:训练截止》细讲)。
一句话收住:它不是去查答案,它是在接话。
那么问题来了:光会接话,凭什么能写方案、算账、写代码?答案要从它是怎么练出来的说起。
二、接话的本事从哪来:读完一座图书馆,再读几万座
想接得准,就得见得多。研发公司从网上收集海量文字,网页、书籍、论文、代码、论坛帖子,统统喂给它。然后反复练一件事:把一句话的下一个词遮住,让它猜;猜完揭晓答案,猜错了就调整自己。这个阶段,业内叫预训练。
读了多少?拿你用过的 DeepSeek 举例。2024 年 12 月,DeepSeek 公开了 V3 模型的技术报告:训练时一共读了 14.8 万亿个“词元”。词元是它读文字的单位,你可以先粗略当成“一个字”(下一篇细讲)。
14.8 万亿是什么概念?一个人每分钟读 300 字,每天读 8 小时,一年下来大约读 5000 万字。照这个速度读完 14.8 万亿,要二十多万年。
一句话收住:人写下的文字里本来就装着知识和做事的方法,它读得足够多、接得足够准,就显得什么都懂。
三、读到的东西存在哪:几千亿个旋钮
读了二十多万年的书,学到的东西放在哪?
想象一台巨大的调音台,上面有几千亿个旋钮。刚开始旋钮都是乱拧的,它接的话是一堆乱码。每猜错一次,就把跟这次有关的旋钮拧一点点,让下次更接近正确答案。这样拧了几万亿次以后,“什么话后面接什么”的规律,就藏在这组旋钮的位置里。
这些旋钮,业内叫参数。DeepSeek-V3 有 6710 亿个参数。你在网上看到的“7B”“70B”“671B”,B 就是十亿,说的就是参数有多少。参数越多,能装下的规律越细,但跑起来也越贵、越慢(选哪种模型划算,见《模型怎么选、钱花在哪》)。
注意,它不是把书一本本存了进去,而是把读书时摸到的规律存进了旋钮里。就像你读了一万本小说,记住的主要是“故事一般怎么写”,而不是每一页的原话。
旋钮还有一个关键特点:练完就定型了。 你每天跟它聊天,它不会因为你多说了几句就学会新东西。它能“记住”你说过的话,是因为软件把聊天记录又塞回了前文里(《聊久了它就忘:上下文》细讲)。
一句话收住:学到的规律存在旋钮里,练完就定型,你跟它聊天改变不了它。
四、你按下回车之后的那两三秒
现在回到开头的问题:你提问以后,那两三秒里发生了什么?
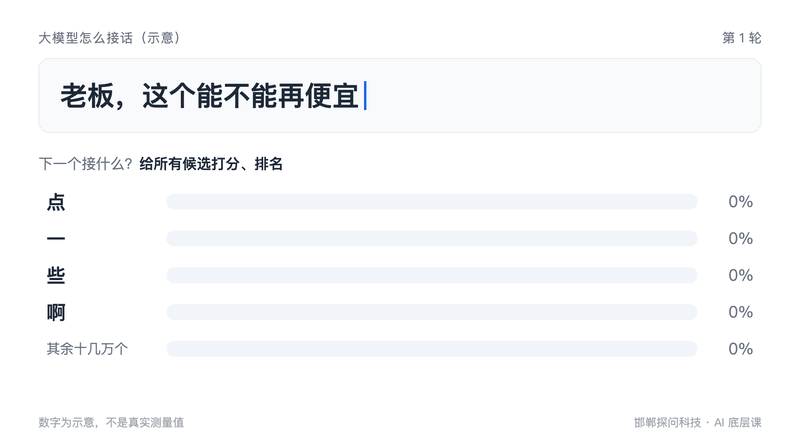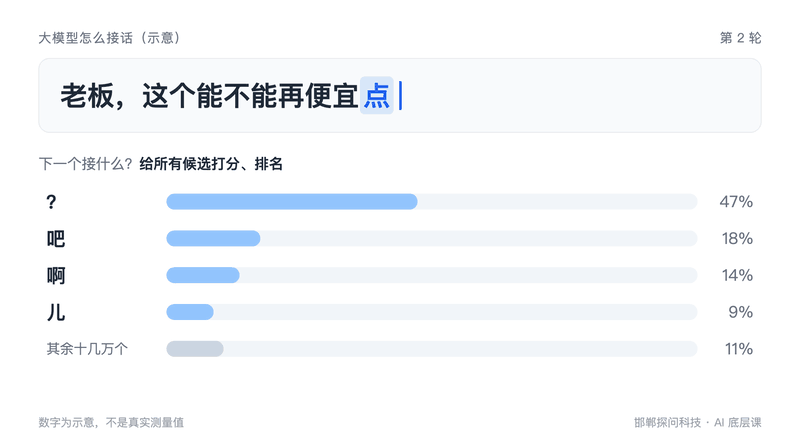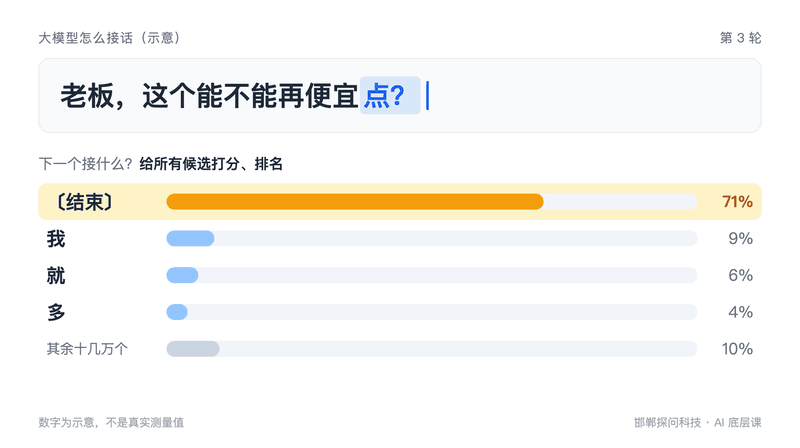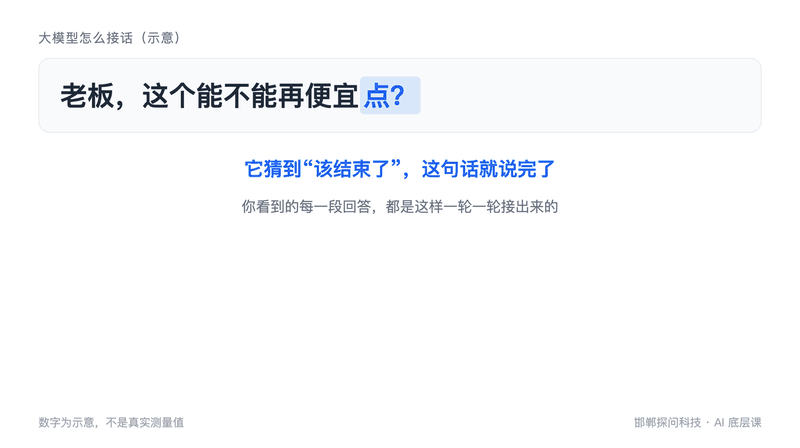
它会把你的问题当开头,用那几千亿个旋钮算一遍,给每一个可能接在后面的词元都打一个分,排出名次。DeepSeek-V3 认识的词元大约有 12.9 万种,所以每接一个字,它都要给这十几万个候选打一遍分。然后挑一个接上,再拿接长了的整句话,从头再算一遍。
下面这张动图演示的就是这个过程(数字是示意,不是真实测量值):
注意两件事:
第一,它也会猜“该结束了”。当“结束”这个选项排到第一,回答就停下来。
第二,排第一的也不一定被选中。它挑的时候会带一点随机,大多数时候挑第一名,偶尔挑第二、第三名。所以同一个问题问两遍,答案会不一样(为什么、怎么利用,见《同一个问题,两次答案不一样:随机性》)。
它怎么知道前面在说什么? 每接一个字之前,它都会回头把前面所有的词看一遍,跟现在最相关的多看几眼,不相关的扫一眼就过。这个机制业内叫注意力,是今天几乎所有大模型的核心。
看个例子,同样是“苹果”两个字:
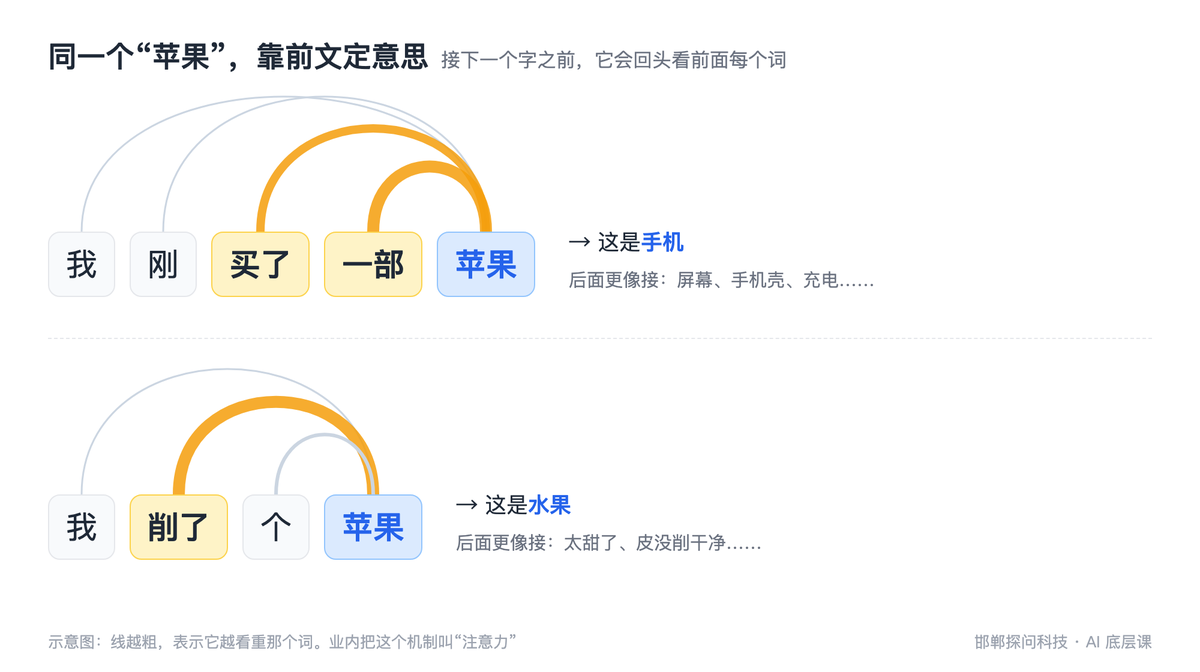
“我刚买了一部苹果”,它盯着“买了一部”,知道这是手机,后面就接“屏幕”“手机壳”;“我削了个苹果”,它盯着“削了”,知道这是水果,后面就接“太甜了”。
同一个词是什么意思、后面该接什么,全看前面给了什么。 这就是“你给它的信息越清楚,它答得越准”的根本原因,不是使用技巧,是工作原理。
一句话收住:它每接一个字,都要给十几万个候选打分排名,排名靠的是前文。
五、为什么它像个助手:还有一道调教
你可能会想:既然它只是接话,为什么你问它问题,它会老老实实回答,而不是接着往下编?
因为只读过书的模型,还真不会好好答题。你问一个只做过预训练的模型“中国的首都是哪里?”,它很可能接着写“美国的首都是哪里?法国的首都是哪里?”。它在网上见过太多这种题目清单,觉得接着出题“最像”。这时候的它,是一台“续写机”,不是助手。
所以研发公司还要再调教两轮:
- 照着示范学:请人写大量“问题加好回答”的示范,让它照着学,学会“有人问,我就答”。业内叫微调。
- 让人来打分:让它对同一个问题写几个回答,请人挑出更好的那个,再按人的喜好继续拧旋钮。业内叫基于人类反馈的强化学习。
这两轮调教有多管用?2022 年 OpenAI 发表的一项研究里,一个只有 13 亿参数、但经过这两轮调教的模型,测评人员更喜欢它的回答,胜过 1750 亿参数、没经过调教的 GPT-3。参数差了一百多倍,“会不会当助手”比“读了多少书”更影响好不好用。
这道调教也给它留下了一个性格:它被训练得想让人满意。 所以它容易顺着你说,你的方案它总说好,你的观点它总说有道理(《它是怎么练出来的:预训练和微调》细讲,并教你怎么让它说真话)。
整个过程,用一张图看全:
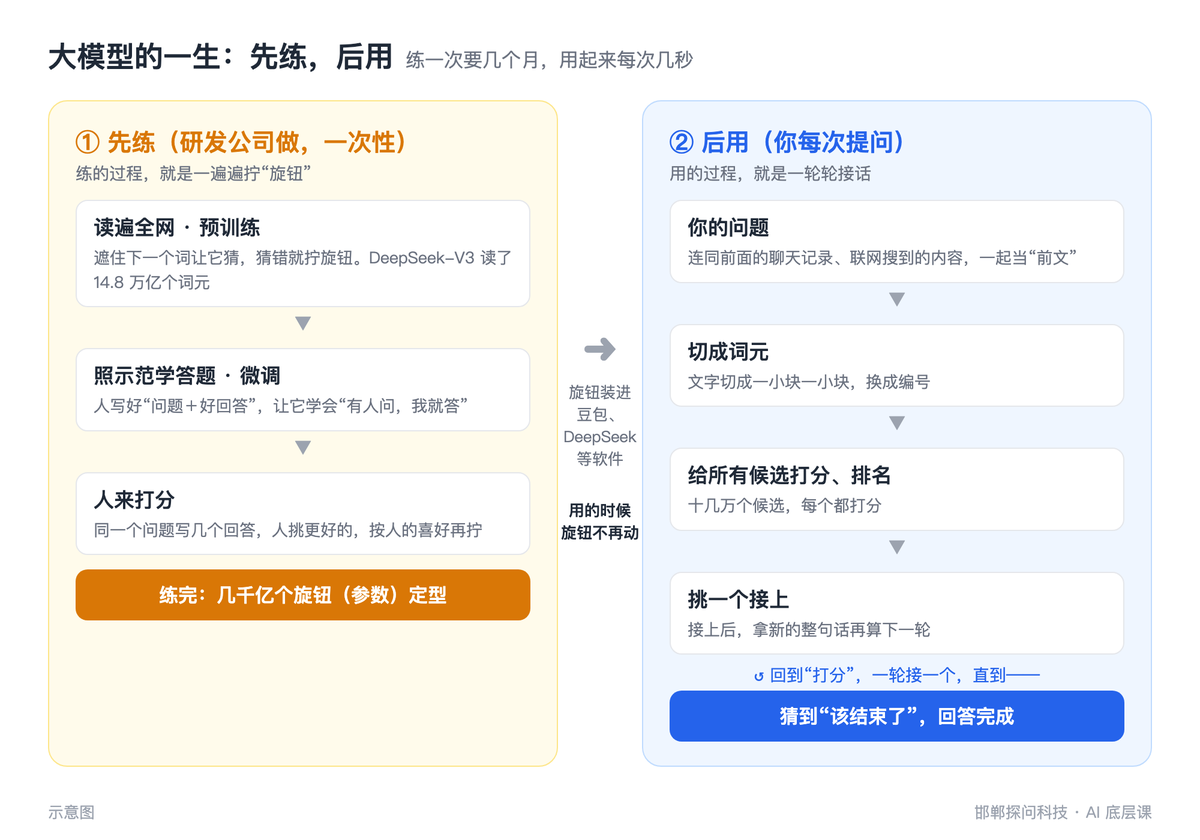
一句话收住:只读过书的是续写机,调教过才是助手,也因此它爱讨好你。
六、所以,它给你的是“最像答案的话”
把前面串起来,结论只有一句:它给你的,是“最像答案的话”,不是查出来的答案。
大多数时候,“最像的”就是对的,因为正确的说法在它读过的文字里出现得最多。但遇到这几类问题,它就容易接错:
- 读过的文字里很少出现的事,比如一家小公司的情况、一个小地方的政策;
- 需要一步步精确计算的事,比如算账、比大小;
- 跟某个常见说法长得很像、但其实不一样的事。
而且它接错的时候,语气跟接对时一样笃定、一样有条理。
一个有名的例子:2024 年夏天,网上流行问 AI“9.11 和 9.9 哪个大?”,当时不少主流大模型都答“9.11 更大”。它在接“最像的”,而不是在做算术。后来的模型专门练过,又有了“先想再答”的能力(见《先打草稿再回答:思考模式》),现在大多能答对了。但“最像的不一定是对的”,这个道理没变。
把没有的事说得跟真的一样,业内叫幻觉,《一本正经地胡说:AI 幻觉》专门讲怎么防。
你可能会想:既然它会错,还敢用吗?敢用。大多数时候“最像的”就是对的,你只要知道它在哪几类事上容易错,那几处由你把关就行。下一节就讲怎么把关。
七、这对你用 AI 意味着什么
| 它的原理 | 所以你该 |
|---|---|
| 它靠前文决定往哪接 | 把话说清楚:你是做什么的、给谁看、要什么结果、什么口气、多长。说得越清楚,答得越准 |
| 旋钮里没有你家的事 | 把资料给它:你家的产品、价格、客户情况,它不可能“知道”,得你喂给它(见《知识库=让它开卷考试》) |
| 它给的是最像的,不是查来的 | 事实自己核:人名、数字、日期、政策、法条,用之前自己核一遍,或让它给出处 |
| 每次挑字带一点随机 | 好东西多要几版:写标题、想点子,让它一次出 5 个挑;要稳定的格式,就把要求写死 |
| 它被调教得想让人满意 | 让它挑毛病:别问“我这个方案好不好”,要问“这个方案最可能在哪儿出问题” |
速查卡
| 记住这几句 | 意思 | 细讲 |
|---|---|---|
| 大模型在接话 | 看前面的话,猜下一个词元,一个一个接成整段 | 本篇 |
| 预训练 | 读遍全网,反复练“猜下一个词”。DeepSeek-V3 读了 14.8 万亿个词元 | 《它是怎么练出来的:预训练和微调》 |
| 参数 | 几千亿个“旋钮”,规律存在旋钮的位置里;练完就定型,聊天不会改变它 | 本篇 |
| 每接一个字 | 给十几万个候选打分排名,挑一个接上,带一点随机 | 本篇;随机那部分见《同一个问题,两次答案不一样:随机性》 |
| 注意力 | 接每个字之前回头看前文,最相关的多看几眼;同一个词什么意思,靠前文定 | 本篇 |
| 微调和人类打分 | 把“续写机”调教成“助手”,也让它变得想让人满意 | 《它是怎么练出来的:预训练和微调》 |
| 联网搜索 | 软件替它搜,搜到的内容塞进前文,它还是在接话 | 《它的知识停在某一天:训练截止》 |
| 最像的答案 | 它给的是“最像答案的话”,不是查出来的答案 | 《一本正经地胡说:AI 幻觉》 |
更多名词见《AI 名词表》。
动手练习(5 分钟)
练习:先看它接话,再给它前文
第一步,看它接话。 复制下面这段,发给豆包或 WorkBuddy:
我说半句话,你只接下一个字。
请给出你觉得最可能的 5 个字,按可能性从高到低排,并估一下每个字的可能性是百分之多少。
半句话:老板,这个能不能再便宜
把它的排名和第四节的动图对一对。注意:它内部确实在打分,但看不见自己的分数,这些百分比本身也是“接”出来的,不能全信。
第二步,同一件事问两遍。 先随口问:
帮我写一条朋友圈再说清楚问一遍(把方括号里的换成你自己的):
帮我写一条朋友圈。
我是做[你的行业]的,这次想说的是[新品/活动/最近发生的一件事]。
看的人主要是[你的客户是什么人]。
我希望他们看完[来问价/到店/转给朋友]。
口气像跟老朋友聊天,不超过 100 字,不用"惊爆""限时抢"这类词。两个答案摆在一起看:哪一条你敢直接发? 对照第四节“苹果”那张图想一想:第二遍你多给了它哪些“前文”?
常见问题
问:它到底懂不懂? 答:它没有人那样的想法和经历,但把海量文字里的规律学得足够细,很多活确实干得了。最贴切的理解是:一个读书极多、反应极快,但不认识你的新员工。不认识你,就要你把情况交代清楚。
问:我跟它说过的事,它下次还记得吗? 答:旋钮练完就不变了,它本身记不住你。有些软件有“记忆”功能,原理是把你以前说过的要点存下来,下次自动塞进前文。所以重要的事,最好整理成一份资料,每次给它(见《知识库=让它开卷考试》)。
下一篇
《它是按字块读的:词元(token)》:为什么你让它写 100 字,它总写不准;为什么同样一份文件,有的 AI 收费贵、有的便宜。
参考资料
- DeepSeek-AI,《DeepSeek-V3 Technical Report》,2024 年 12 月(6710 亿参数、14.8 万亿词元、词元表约 12.9 万)
- Vaswani 等,《Attention Is All You Need》,2017 年(注意力机制)
- Ouyang 等,《Training language models to follow instructions with human feedback》,2022 年(13 亿参数调教版胜过 1750 亿参数 GPT-3)
学完测一测
4 道题,答对 3 道算过关
先别往回翻,凭读完的印象选。交卷后每道题都有讲解。
你在豆包里问一个问题,几秒后它回了一大段。这段回答是怎么来的?
上周你跟 AI 聊了半天你家店的情况,这周新开一个对话,它全不记得了。最根本的原因是什么?
一位饭店老板想让 AI 帮忙写一条新菜上市的宣传文案。照文章的道理,他最该怎么做?
你让 AI 写一篇介绍本地创业补贴的文章,它写得条理清楚,里面有具体条款和金额。你最该怎么做?