你让 AI 写一条朋友圈,宣传周末的会员活动。第一版出来,有点长,你补了一句:
以后每一版都不超过 100 字,别用感叹号。
它照办了。接着你又提了一堆意见:开头换个说法、价格往前放、口气再亲切点……改到第十几轮,它交上来一版:三百来字,满屏感叹号。
你心里一句:“它是不是在敷衍我?”
不是敷衍。你交代的那两条,被挤到了它看不清的地方。这篇讲清楚,那是个什么地方。
一、先说一个误会:它没有记性,是软件在替它重念
很多人以为,AI 跟人一样把聊过的事记在脑子里,聊久了就“记性不好”或者“不上心”。
不是。前面讲过,大模型练完就定型了,你跟它聊天,它本身一个字都不会记住(见《大模型是怎么回答你的》)。那它为什么还能接着你上一句往下说?
因为软件每次都把前面的聊天记录,从头到尾重新发给它一遍。 你发第 15 句的时候,软件实际发过去的是这样一大段:
软件对大模型说:“这是你们前面聊的 14 轮,一字不落:第 1 轮用户说……你回了……第 2 轮用户说……你回了……现在用户又说:价格往前放。你接着回。”
DeepSeek 的官方文档写得很直白:它的对话接口是“无状态”的,服务器不记你们聊过什么,每次都要把之前所有的对话拼好一起发过去。豆包、元宝也是在背后替你拼好再发。
这就是《智能体是怎么替你干活的》里那个比方:大模型是只能打电话、不记事的老师傅,每通电话都得把前面的事从头念一遍。
一句话收住:它记得前面的话,是因为软件每次都把前面的话从头念给它听。
二、念的稿子有长度上限:上下文窗口
从头念,就有个问题:念的稿子不能无限长。
你发给它的每一句,加上它自己说过的每一句,再加上你附的文件,这一整段它这一次能“看见”的内容,业内叫上下文。这一段最长能有多长,叫上下文窗口。说人话:老师傅一通电话最多能听多少。
这个长度是按词元算的(词元是什么,见《它是按字块读的:词元(token)》)。截至 2026 年 11 月,DeepSeek 官方文档写的上下文长度是 100 万词元,按“一个汉字约 0.6 个词元”换算,大约一百六十多万字。不过这是接口上的数,网页版、App 里实际给你多长,各家不一定公开。
超过了上限怎么办?只能丢。有的软件直接把最早的几轮截掉,有的把前面的内容压成一段摘要再接着聊。截掉的,它就真看不见了;压成摘要的,细节难免丢掉一些,你早先交代的规矩很可能就在里面。最早说的话,最先被丢。
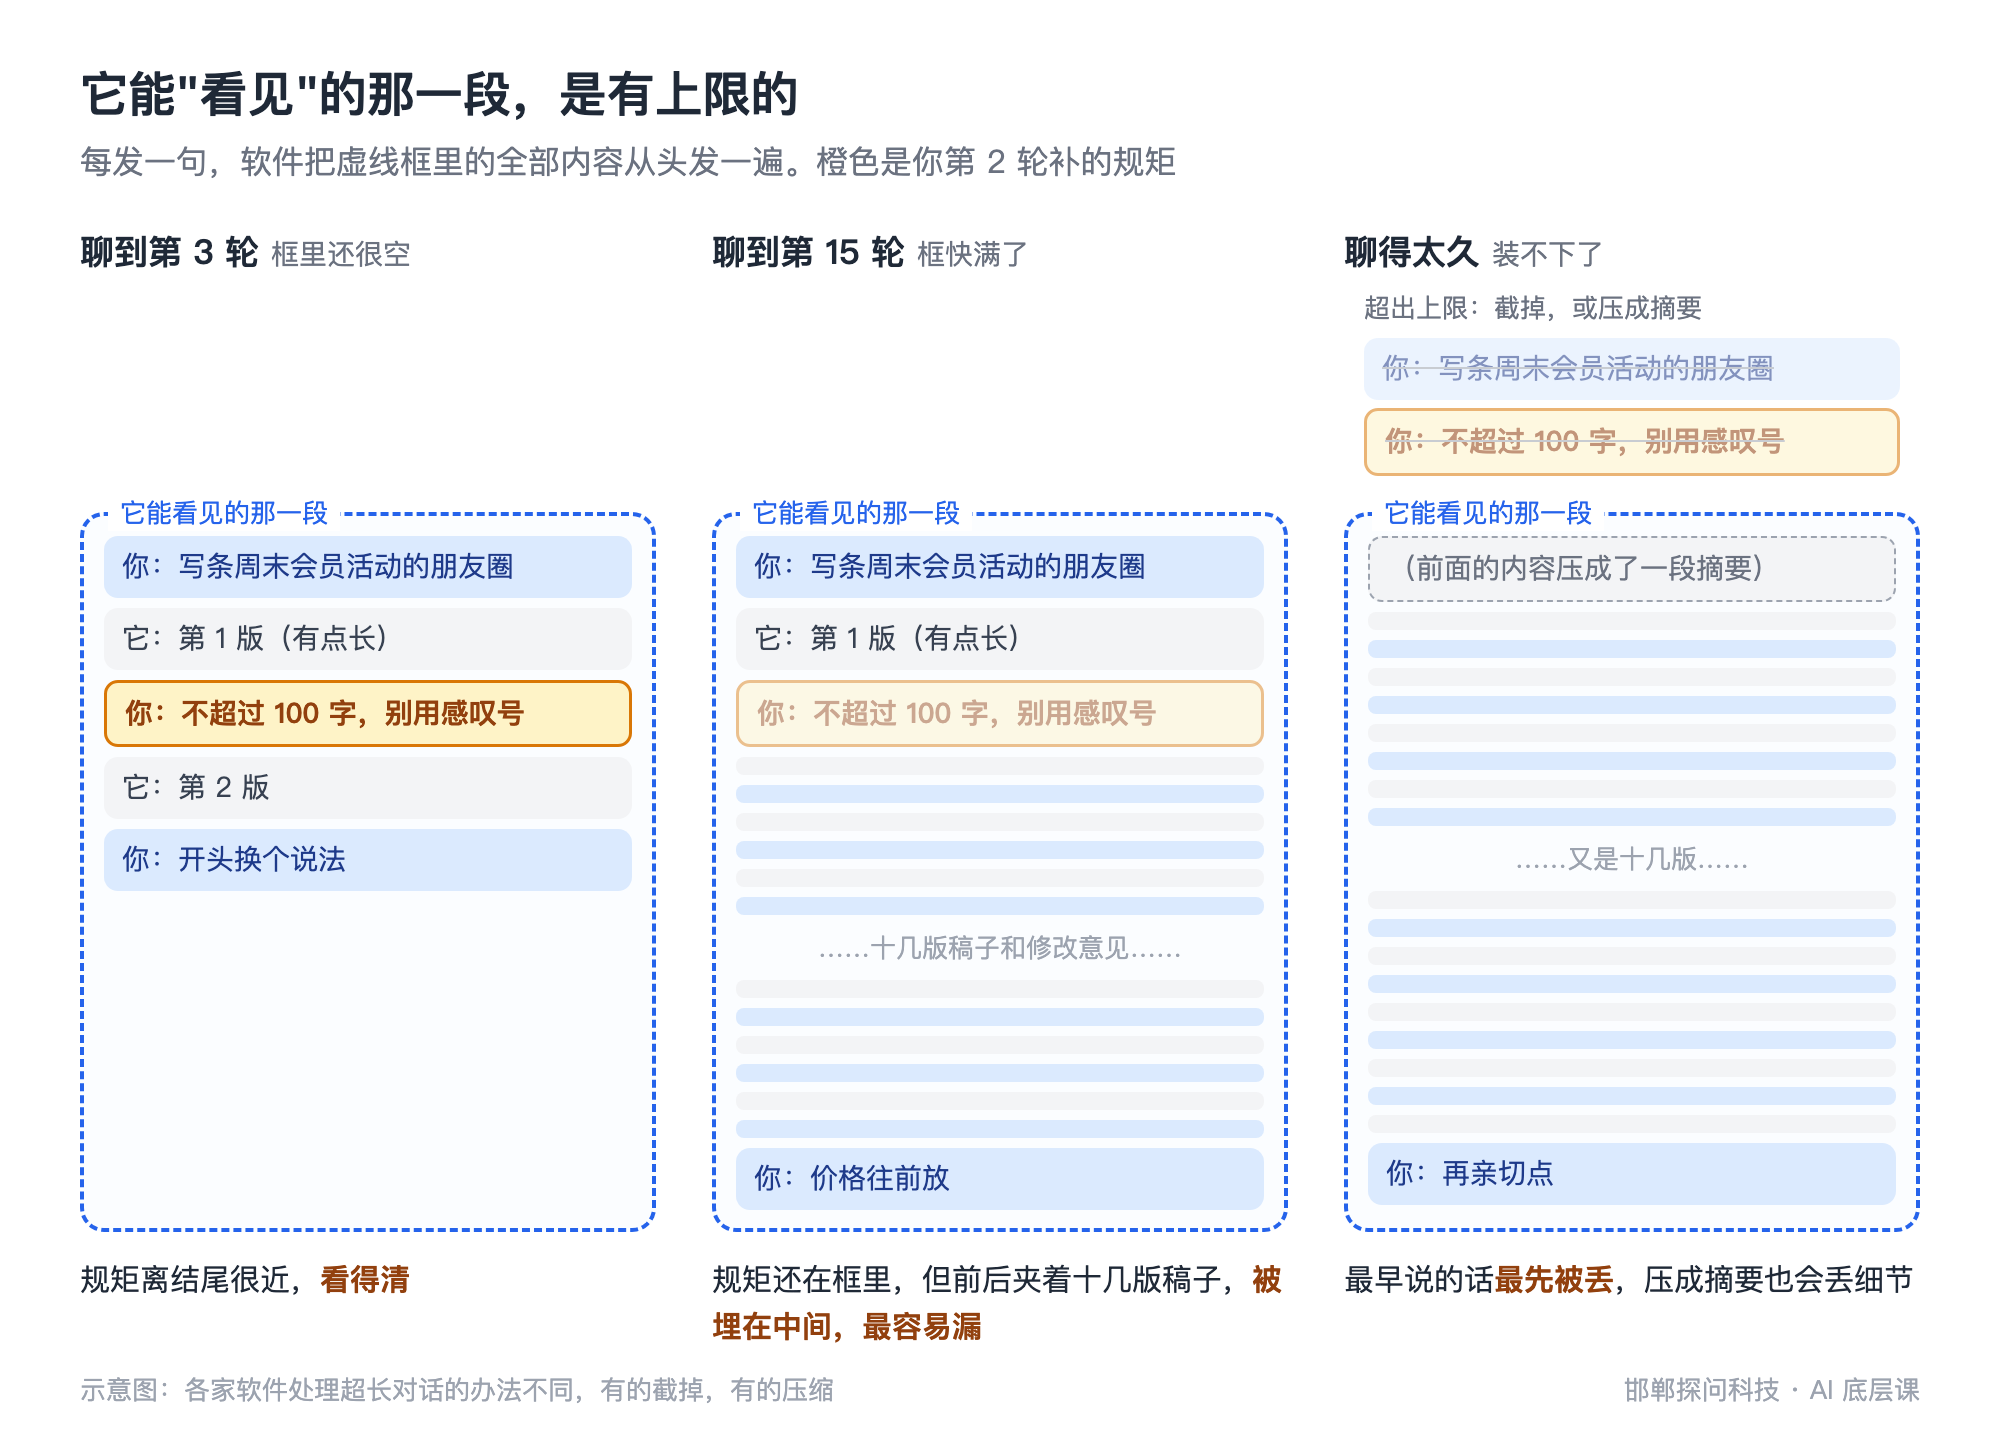
一句话收住:它能看见的那一段是有限的,装不下的,它就真看不见了。
三、装得下也会漏:中间最容易看漏
这时候你可能会说:一百万词元,我聊十几轮才几千字,怎么也装得下啊,为什么还会忘?
这话对,装是装得下。但装得下,不等于看得清。
2023 年,斯坦福大学等机构的研究人员做过一个实验,论文叫《Lost in the Middle》,中文常译作“迷失在中间”:
- 拿真实的搜索问题去问模型,比如论文里举的“第一个诺贝尔物理学奖颁给了谁”;
- 同时给它 20 段维基百科资料,只有 1 段里有答案,另外 19 段是检索出来的、看着相关但没有答案的段落;
- 把有答案的那一段,挨个挪到第 1 份、第 5 份、第 10 份……第 20 份,看它答对多少。
20 段资料加起来大约 4000 个词元,被测的 GPT-3.5-Turbo(16K 版)一次能看 1.6 万词元,只用了四分之一,绝对装得下。结果是这样的:
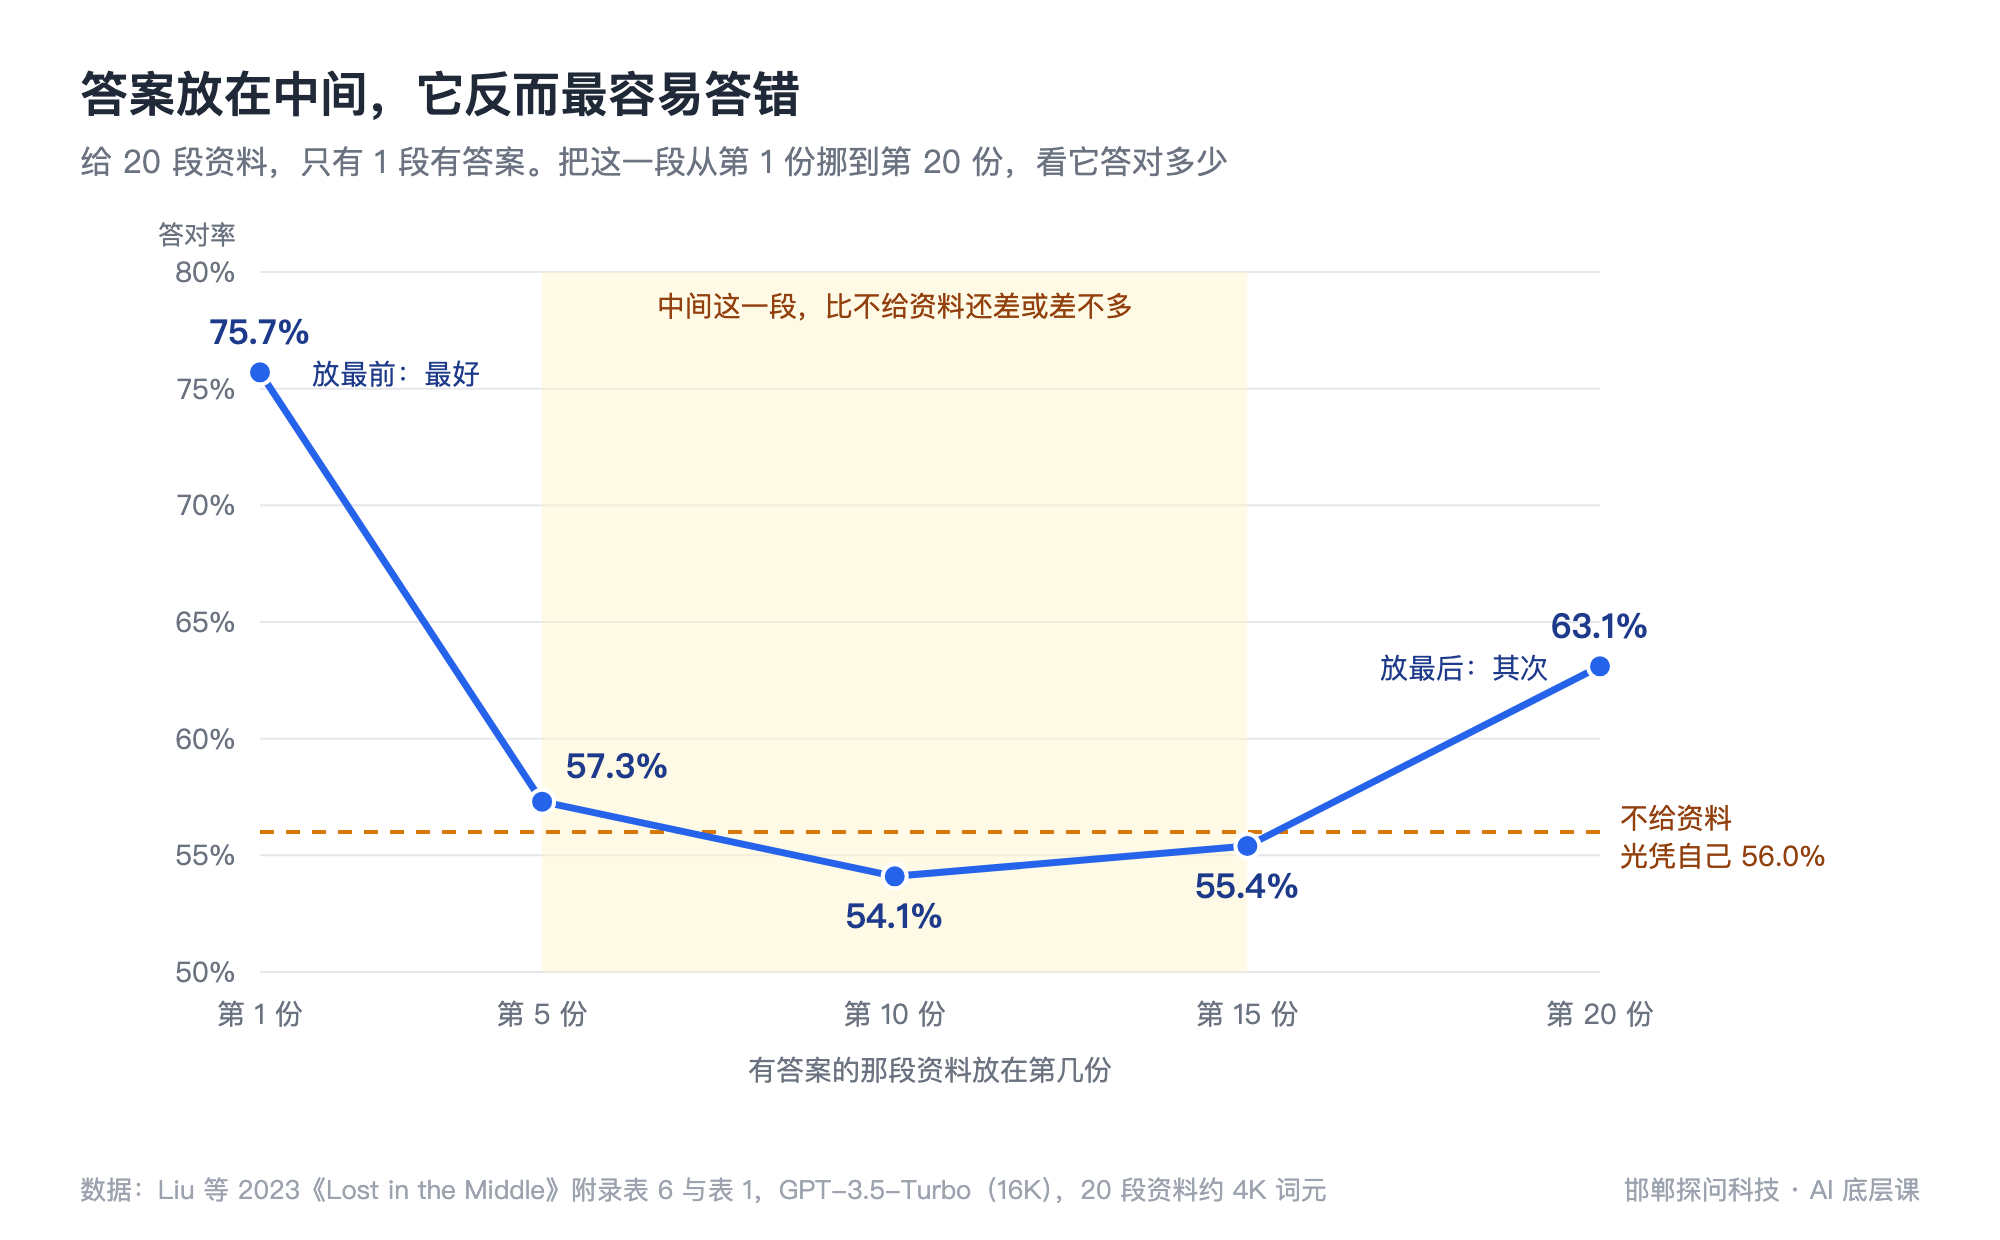
- 答案在第 1 份:答对 75.7%;
- 答案在最后一份:答对 63.1%;
- 答案在第 10 份,正中间:只答对 54.1%。
最扎心的是:一份资料都不给它、让它光凭自己读过的书硬答,能答对 56.0%。 答案放在中间,比不给资料还差。
画出来是一条 U 形线:开头看得最清楚,结尾其次,中间最容易漏。
这是 2023 年的模型。2025 年 Chroma 公司测了 18 个主流模型(包括千问 Qwen3),在“从一大段里找出一句原话”这种简单测试上,放在哪儿已经没多大差别;但总结论是:输入越长,表现越往下掉,哪怕任务很简单。
回到开头那条朋友圈:你那两条规矩是第 2 轮补的。聊到第十几轮,它还在能看见的那一段里,可前面压着第一版稿子,后面跟着十几版稿子和一堆新意见,正好被夹在了中间。
一句话收住:内容越多,它越容易看漏,最容易漏的是中间。
四、它说的“记忆”,是软件替它记小抄
有人会问:可有的 AI 软件明明有“记忆”功能,上个月说过的事,它这个月还记得。
原理还是一样。软件把你聊过的要点挑出来存着;下次开新对话,悄悄把这些要点塞进开头,跟你的问题一起发过去。还是把东西重新塞进它能看见的那一段,只不过不是整段聊天记录,是一张小抄。
小抄由软件挑,挑什么、记多少,你说了不算。所以真正靠得住的长期记忆,是你自己把要点写进一份文件,让它每次开工前先读:
- Codex 动手前,会先读工作文件夹里一份叫 AGENTS.md 的说明文件(腾讯的 CodeBuddy 读 CODEBUDDY.md),你家的规矩写在里面,每次都会被念到;
- 用聊天软件,也可以存一份“我家情况”的文档,每开一个新对话先贴进去。
把这件事做得更系统,就是《知识库=让它开卷考试》和《技能=给 AI 一本操作手册》要讲的。
一句话收住:所有“记忆”,说到底都是把要点重新塞进它能看见的那一段。
五、怎么用:要紧的放两头,聊乱了就开新对话
明白了原理,办法就很直接。
第一,要紧的放两头。 开头和结尾它看得最清楚,就把最要紧的放在这两个地方:
- 规矩开头就说:字数、口气、不许做什么,第一句就交代;
- 要贴长资料,资料放前面,问题和关键要求放在最后再说一遍。Anthropic(Claude 的研发公司)的官方建议也是这样,他们实测回答质量最多能提高三成。
第二,聊乱了就开新对话。 一看它开始忘规矩、前后矛盾,别在原地纠正十轮。让它把定下来的东西整理成一段,复制到新对话开头重新开始。
第三,一个对话只办一件事。 改完朋友圈,再想写活动海报的文字,新开一个。前面那十几版朋友圈,对海报没用,只会占地方。
你可能会想:开新对话,前面聊的不都白费了?要重新交代一遍,多麻烦。
确实要。但让它总结一段、复制过去,一分钟的事。在一团乱的对话里来回纠正,花的时间更多,还越聊越费钱(每一轮都要从头念,见《它是按字块读的:词元(token)》)。
一句话收住:AI 不是不听话,是你说的话被挤到了它看不清的地方;把要紧的挪回两头,或者干脆换一张干净的稿纸。
六、这对你用 AI 意味着什么
| 它的原理 | 所以你该 |
|---|---|
| 它不记事,软件每次从头念聊天记录 | 别指望它“记得”:重要的规矩,该重说就重说 |
| 能看见的那一段有上限 | 聊太久就换新对话:超过上限,最早的会被截掉或压缩 |
| 开头和结尾看得最清,中间最容易漏 | 要紧的放两头:规矩开头说,长资料放中间,问题和要求最后再说一遍 |
| 内容越长越不稳 | 只给用得上的:一个对话只办一件事,无关的稿子和资料别堆着 |
| “记忆”是软件塞小抄 | 长期要用的写成文件:自家情况、写作规矩存成一份,每次开工先给它 |
速查卡
| 记住这几句 | 意思 | 细讲 |
|---|---|---|
| 上下文 | 它这一次能“看见”的全部内容:聊天记录、文件、你刚说的话 | 本篇 |
| 上下文窗口 | 这一段最长能有多长,按词元算,超了就截掉或压缩 | 本篇 |
| 中间迷失(Lost in the Middle) | 开头和结尾看得清,中间最容易漏;放中间甚至比不给资料还差 | 本篇 |
| 它为什么“记得” | 软件每次把前面的聊天记录从头发一遍 | 本篇 |
| 记忆功能 | 软件挑出要点,下次悄悄塞进开头 | 本篇 |
| 长期记忆 | 你自己把要点写进文件,让它每次先读 | 《技能=给 AI 一本操作手册》 |
| 词元 | 它读文字的单位,窗口和价钱都按它算 | 《它是按字块读的:词元(token)》 |
| 老师傅不记事 | 大模型只能打电话、不记事,智能体是带着本子的徒弟 | 《智能体是怎么替你干活的》 |
动手练习(5 分钟)
练习:给一个聊乱了的对话写交接单
找一个你跟 AI 聊了很久的对话(豆包、DeepSeek 都行),在最后发:
我们这个对话聊得太长了,我要换一个新对话接着做。
请把到现在为止已经定下来的东西整理成一段"交接单",包括:
1. 这件事是要做什么、给谁看
2. 我提过的所有要求和不许做的事(一条都别漏,尤其是中途补充的)
3. 现在最新的一版稿子
不用解释,直接给我能复制的交接单。
把交接单复制到一个新对话里,在后面接着提你的下一个要求。对比一下,新对话里它是不是又守规矩了?顺便看看交接单里,有没有漏掉你开头说过的话。
常见问题
问:开了“记忆”功能,是不是就不用开新对话了? 答:不是。记忆功能只存零零星星的要点,存哪些由软件挑。它解决的是“下次不用从头介绍自己”,解决不了“这个对话太长、看不清”。重要的规矩,还是自己写成文件靠得住。
问:智能体干长活,也会忘吗? 答:会,而且更容易。智能体一件活要打几十通电话,每一通都从头念,很快就长了。所以 Claude Code、Codex 这类智能体聊长了会把前面的内容压成摘要再接着干。压缩会丢细节,所以要紧的规矩写进 AGENTS.md 这类说明文件里,它每次开工都会重新读到。
下一篇
《提示词为什么要这么写》:知道了它只看得见你给的那一段,下一步就是把那一段写好:身份、背景、要求、样子,四样说清楚。
参考资料
- Liu, Lin, Hewitt, Paranjape, Bevilacqua, Petroni, Liang,《Lost in the Middle: How Language Models Use Long Contexts》,2023 年,发表于 TACL(斯坦福大学、加州大学伯克利分校、Samaya AI):20 段资料(约 4K 词元)的多文档问答,GPT-3.5-Turbo(16K)答案在第 1、5、10、15、20 份时分别答对 75.7%、57.3%、54.1%、55.4%、63.1%(附录表 6);不给资料 56.0%(表 1)
- Hong, Troynikov, Huber,《Context Rot: How Increasing Input Tokens Impacts LLM Performance》,Chroma 技术报告,2025 年 7 月:测了 18 个模型(含 Qwen3),输入越长表现越下降
- DeepSeek API 文档,《多轮对话》(查阅于 2026 年 11 月 4 日):对话接口是“无状态”的,每次请求需把之前所有对话历史拼接好再发
- DeepSeek API 文档,《模型 & 价格》(查阅于 2026 年 11 月 4 日):上下文长度 1M;《Token 用量计算》:1 个中文字符约 0.6 个 token
- Anthropic,Claude 官方文档《Prompting best practices》长文档部分(查阅于 2026 年 11 月 4 日):长文档放在提示词前面、问题放在最后,测试中回答质量最多提升 30%
- OpenAI,Codex 官方文档《AGENTS.md》:Codex 开工前会先读 AGENTS.md
- Anthropic,Claude Code 官方文档:/compact 命令把对话压缩成摘要后接着聊
- 腾讯云,CodeBuddy 文档《记忆》:用 CODEBUDDY.md 存项目级和用户级记忆,启动时自动加载
学完测一测
4 道题,答对 3 道算过关
先别往回翻,凭读完的印象选。交卷后每道题都有讲解。
你跟 AI 聊到第十几轮,它还能接着你上一句往下说。这是怎么做到的?
你们聊了十几轮,加起来才几千字,远没到上限,可你第 2 轮交代的"不超过 100 字",它还是没照做。最可能的原因是什么?
你要 AI 根据一份很长的会员活动方案写一条通知。资料和要求怎么排最好?
一条朋友圈你改了十几轮,它开始忘规矩、前后矛盾。最该怎么做?